Como decidir entre modelos especializados e LLMs? Jev e a ascensão dos System One Models
No atual estágio de maturidade corporativa, a inteligência artificial ultrapassou a fase experimental dos protótipos de laboratório. O grande desafio das lideranças de tecnologia e negócios hoje é de engenharia de valor e governança: como escalar soluções inteligentes sem criar gargalos operacionais ou contas imprevisíveis de nuvem que inviabilizam o ROI.
Durante os últimos anos, o mercado adotou uma postura quase monocultural: diante de qualquer problema que envolvesse texto ou dados não estruturados — seja classificar uma mensagem, extrair metadados, rotear um chamado técnico ou avaliar um risco —, a resposta padrão foi plugar a API de um LLM (Large Language Model).
No entanto, em cenários corporativos de alto volume e repetição contínua, o uso de LLMs de propósito geral revela fissuras arquitetônicas severas: alta latência, custos cumulativos de tokens de entrada e saída, e a fragilidade de sistemas que precisam interpretar respostas em texto corrido.
É nesse cenário de fricção que surge uma nova classe arquitetural: os Modelos de Sistema 1 (System One Models), encabeçados pelo Jev, desenvolvido pela Typesafe AI, e pela Laya, sua contraparte de código aberto.
Na Squadra, onde a governança de inteligência artificial é a base fundacional da plataforma Genius AI, exploramos profundamente como essa transição técnica altera as decisões de negócio e o orçamento das empresas.
O que é o Jev e o conceito de System One?
Para compreender o Jev, é útil resgatar a teoria da psicologia cognitiva formulada por Daniel Kahneman sobre a mente humana:
Sistema 1: operações mentais rápidas, automáticas, instintivas e de baixo gasto energético (reconhecer uma expressão facial, desviar de um obstáculo, classificar um estímulo em frações de segundo);
Sistema 2: raciocínio lento, deliberado, computacionalmente custoso e consciente (resolver um cálculo complexo, escrever um ensaio crítico, elaborar um contrato).
Os LLMs tradicionais e os recentes modelos de raciocínio lógico tentam replicar o Sistema 2 ou agir como grandes geradores de discurso. Eles operam de forma auto-regressiva, calculando a probabilidade da próxima sequência, o que custa caro em capacidade computacional e tempo.
O Jev foi projetado para atuar estritamente como o Sistema 1 da IA corporativa.
A Typesafe AI define o modelo como uma função de chamada de inteligência de fronteira: ele consome texto livre e não estruturado, mas não devolve conversa. Ele devolve diretamente decisões estruturadas, tipadas e calibradas com rigor matemático.
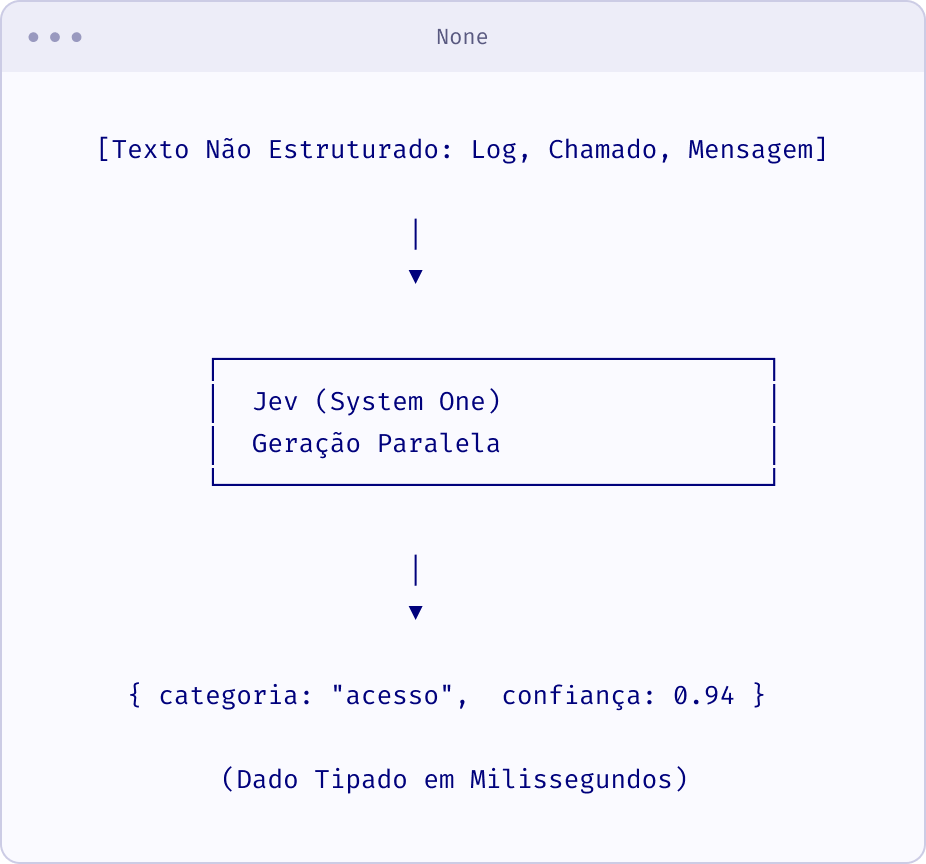
A base do Jev apoia-se em três pilares técnicos:
1. Decisão tipada (typed output) e fim do parsing
Em integrações com LLMs tradicionais, desenvolvedores gastam esforço contínuo em prompt engineering para forçar a IA a responder em JSON ou XML. Mesmo com técnicas de decodificação guiada (constrained decoding), o modelo ainda gera strings de texto que precisam ser validadas por analisadores de código (parsers). Se o LLM adiciona uma palavra solta ou quebra a sintaxe, a automação para e exige novas tentativas (retries).
No Jev, os resultados possíveis são definidos via schema antes da inferência. O retorno é tipado nativamente, eliminando camadas frágeis de sanitização de dados.
2. Probabilidades calibradas via RLCD
Um dos maiores perigos dos LLMs na tomada de decisão automatizada é a alucinação convicta: o modelo pode errar grotescamente mantendo um tom de absoluta certeza.
O Jev introduz um método de treinamento proprietário chamado RLCD (Reinforcement Learning for Calibrated Decisions). O foco dessa abordagem não é ensinar o modelo a soar convincente, mas garantir que a probabilidade associada à resposta corresponda à realidade factual. Se o Jev indica uma pontuação de confiança de 0,85 para uma classificação, a taxa de acerto estatística histórica dessa faixa deve de fato se aproximar de 85%.
3. Inferência em paralelo (fim do token-to-token)
Os LLMs convencionais sofrem com latência porque geram a resposta palavra por palavra: o token n depende do cálculo de todos os tokens anteriores.
O Jev processa a extração e a decisão de forma paralela em uma única consulta. Isso desloca a velocidade de inferência da faixa de vários segundos para o patamar de 70 ms a 500 ms, viabilizando fluxos transacionais em tempo real.
Jev vs. Laya: a questão do lock-in e modelos abertos
Assim como o Jev desponta no modelo proprietário sob regime de acesso antecipado (early access), o ecossistema viu surgir a Laya, apresentada como uma alternativa open source. Para arquiteturas corporativas, a escolha entre uma solução gerenciada via API e um modelo aberto traz implicações diretas de governança:
Jev
Entrega simplicidade operacional de SaaS e infraestrutura otimizada pela fornecedora, mas embute riscos de dependência de fornecedor (vendor lock-in) e incertezas quanto à precificação futura após o período de lançamento.
Laya (open source)
Oferece soberania de dados, ausência de taxas por requisição de terceiros e a possibilidade de rodar em infraestrutura própria (on-premises ou nuvem privada). Contudo, transfere para a equipe de engenharia o custo de sustentação, infraestrutura de GPUs e calibração de inferência.
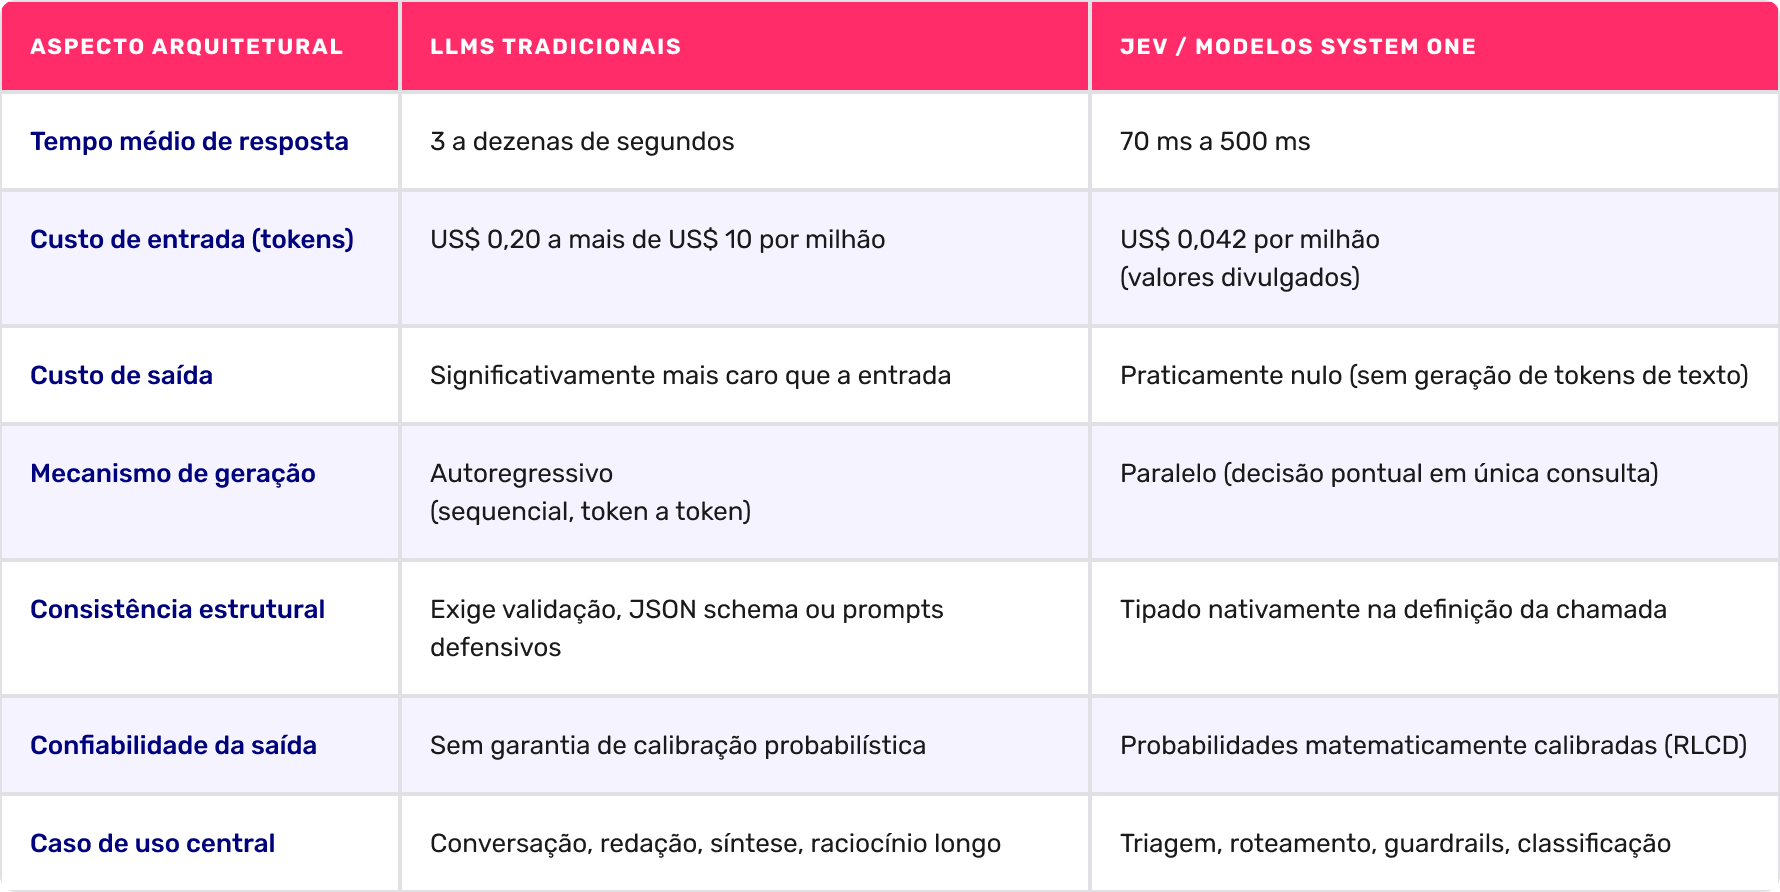
O confronto técnico: LLMs vs. modelos de decisão tipada
Olhar crítico de governança*
Benchmarks que apontam ganhos de 193x em velocidade e 444x em custo divulgados por fabricantes devem ser sempre tratados como hipóteses, e não como dados de orçamento final. Avaliações com a massa de dados real de cada empresa são indispensáveis para comprovar essas métricas em produção.
Estudo de caso prático: triagem de chamados em escala
Para visualizar o impacto financeiro dessa distinção técnica, imagine uma operação corporativa de atendimento ou TI que processa 2.000.000 de chamados por mês.
Cada chamado contém cerca de 800 tokens de contexto não-estruturados (descrição do usuário, histórico preliminar e instruções). O objetivo do sistema é puramente operacional: atribuir uma categoria e um nível de prioridade.
1. Abordagem exclusiva via LLM
O sistema envia os 800 tokens para um modelo conversacional. Além do custo de entrada, o LLM gera cerca de 40 tokens de saída para formular a resposta estruturada.
Custo estimado: 1,6 bilhão de tokens de entrada (~US$1.600) + 80 milhões de tokens de saída (~US$400) US$2.000 mensais;
Problema operacional: latência elevada, dependência de parsers e eventuais quebras quando o modelo tenta ser prestativo e adiciona comentários não solicitados.
2. Abordagem exclusiva via Jev
O sistema submete o chamado com a tipagem fechada preestabelecida.
Custo estimado: 1,6 bilhão de tokens de entrada US$0,042 por milhão US$67 mensais;
Ganho operacional: decisão entregue em centenas de milissegundos, consumida diretamente pelo backend sem tratamento de strings.
Orquestração em cascata com a plataforma Genius
Entendemos que a resposta para a eficiência não é o radicalismo arquitetural. O caminho maduro está na arquitetura em cascata com fallback probabilístico.
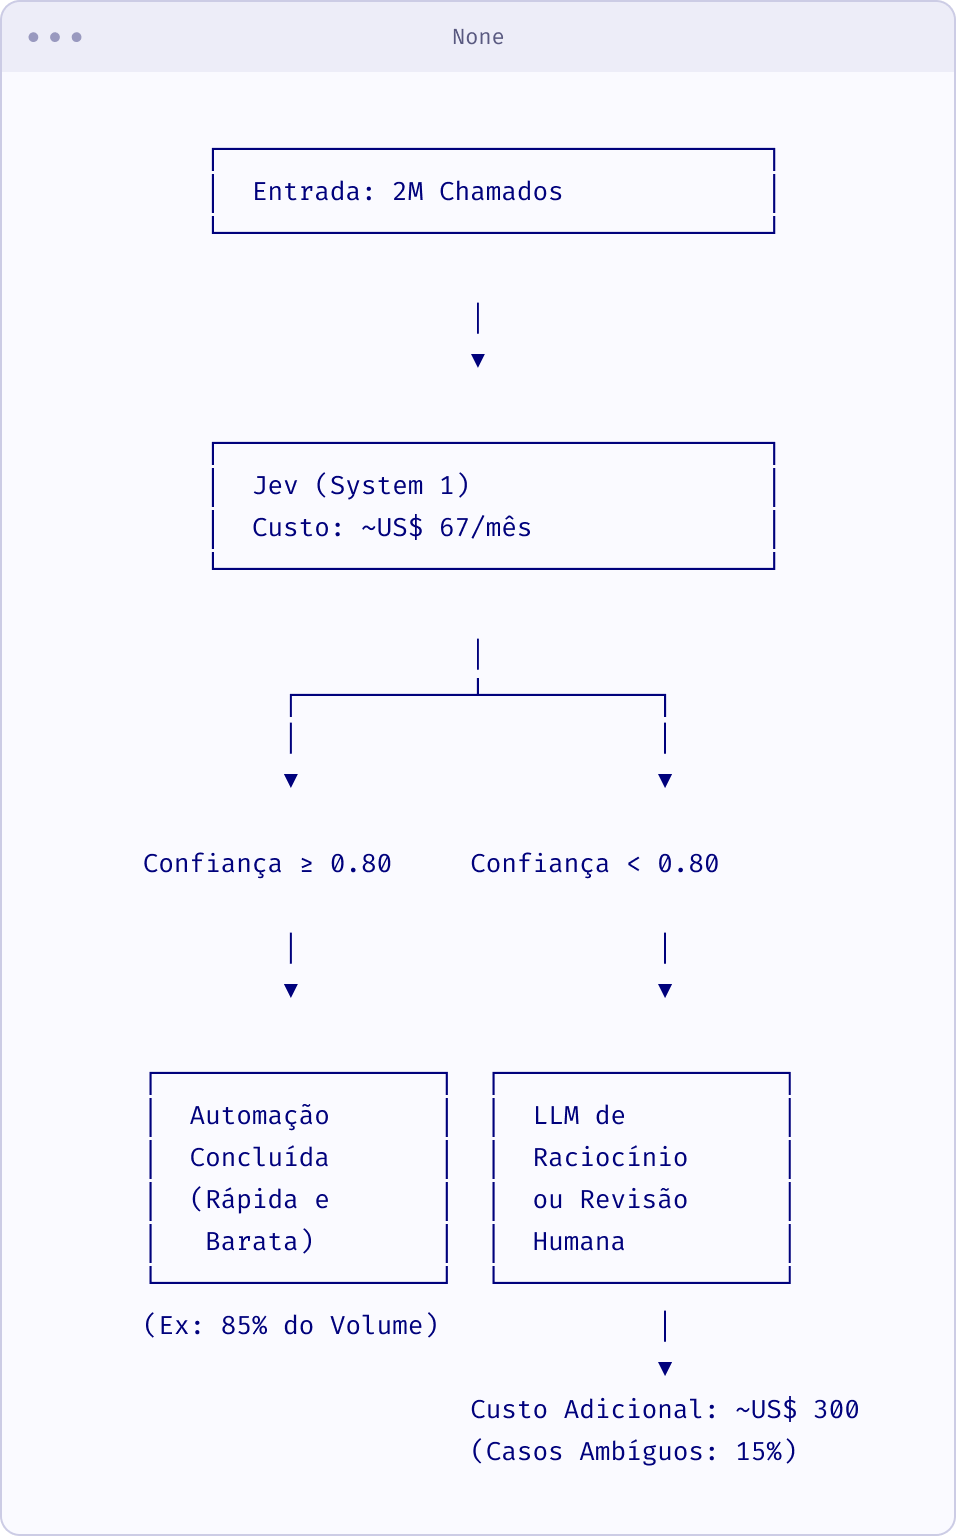
Primeira camada (decisão rápida): 100% dos eventos passam pelo modelo de decisão tipada (Jev ou Laya);
Corte por calibração: o sistema analisa o score de confiança associado à resposta; se a probabilidade for igual ou superior a um limiar estabelecido (por exemplo, 0,80), a decisão é homologada e segue o fluxo automaticamente;
Segunda camada (roteamento especializado): apenas os casos cinzentos e ambíguos (supondo 15% do volume, ou 300 mil chamados) são escalados para um LLM mais denso e caro, capaz de interpretar nuances complexas.
O resultado financeiro
A operação combina o custo de US$67 do System One com cerca de US$300 das chamadas direcionadas ao LLM. A conta total fecha em torno de US$370 por mês — uma redução sustentável de mais de 80% nos custos de inferência, com manutenção da acurácia e ganho substancial de velocidade na maior parte do tráfego.
O framework de validação técnica e de negócio
Para lideranças de produto, CTOs e arquitetos de soluções, a substituição de componentes de IA deve ser amparada por critérios objetivos. Antes de migrar qualquer carga de trabalho para modelos de decisão tipada, quatro passos devem ser executados em um ambiente de prova de conceito (PoC):
1. Rotulagem de gabarito (ground truth)
Separe uma amostra de 300 a 500 instâncias reais da sua operação e rotule manualmente.
2. Teste real de calibração
Avalie se as métricas de confiança da ferramenta refletem a realidade dos seus dados em língua portuguesa: um retorno com confiança 0,90 realmente acerta em 9 a cada 10 vezes no seu domínio de negócio?
3. Medição da taxa de escalonamento
Descubra qual percentual do seu volume precisará recorrer ao fallback do LLM; é essa taxa que dita o custo real da arquitetura mista.
4. Auditoria e governança
Garanta que cada etapa registre os parâmetros de entrada, modelo acionado, nível de confiança e caminho de roteamento para fins de conformidade e segurança da informação.
A revolução corporativa da inteligência artificial não reside na busca incessante pelo modelo mais sofisticado para resolver qualquer tipo de problema.
A verdadeira eficiência vem da disciplina arquitetural: usar linguagem natural quando for mandatório conversar e decisão tipada quando a prioridade for decidir com rapidez, auditabilidade e baixo custo.
Na Squadra, essa é a essência prática que guia o desenvolvimento da Genius AI Platform. Ajudamos organizações a transformar o potencial da IA em alavanca sustentável de negócios, garantindo previsibilidade financeira, governança estrita e eficiência máxima em cada chamada. Fale com nossos especialistas.